2.2|剪輯不燒錢:五個少燒 Token 也能剪完一支片
2. 省 Token 決策總表(課程 5 技巧 + 2026 官方補齊)
| 技巧/作法 | 狀態 | 省錢原理與白話結論 | 官方/實操參考 |
|---|---|---|---|
| 1. 文字代替影片(Whisper) | 定案 | 用本機 whisper-cli 或 Faster Whisper 先轉帶時間軸逐字稿,別讓 Claude 直接看影片。 |
官方費用控管指南 → |
| 2. 讓 AI 先選內容、再剪片 | 定案 | 請 AI 讀逐字稿挑出口誤、停頓與重複段(標註修改前後對照),定案再進剪輯。 | Best Practices → |
| 3. 用 EDL 剪輯決策表存檔 | 定案 | 把保留片段、原因、視覺素材存進表格;微調時改表格秒數即可,不必叫 AI 重看片。 | 外部狀態保存原則 → |
| 4. 先測 8 秒/30 秒小片段 | 定案 | 字幕樣式、動畫節奏先剪 8 秒樣板驗收,OK 再套用到 10 分鐘全片。 | 驗證迴圈指南 → |
| 5. 用「數字」取代模糊形容 | 定案 | 寫 48px、距離底部 120px、淡入 0.25s,別寫「放大一點」讓 AI 來回猜。 |
Remotion Skills → |
| 6. 剪映專業版零 Token 導 SRT | 已上線 | 匯出時取消勾選「影片」、只勾「字幕(SRT)」,零 AI Token 秒出時間軸。 | 見下方步驟 4 實操截圖 |
7. 轉場後立刻 /clear 清記憶 |
要你決定 | 逐字稿挑完並存進 EDL 後,輸入 /clear 歸零歷史再跑 FFmpeg,省 70% 輸入費。 |
/clear 官方說明 → |
8. Subagent 用 haiku 讀素材 |
定案 | 盤點資料夾、讀 ffprobe 規格交給 Haiku 小幫手隔離消化,別塞進主視窗。 |
Subagents 文件 → |
| 9. 鎖定模型別中途切換(保護快取) | 要你決定 | Prompt Cache 讀取只要 0.05x~0.1x 費用,途中切模型會讓快取失效重算全額! | Cache 機制解析 → |
10. 開啟 ENABLE_TOOL_SEARCH |
定案 | MCP 工具延遲載入(auto:5),省下高達 85% 的工具定義開銷。 |
Tool Search 原理 → |
3. 五大技巧圖文實操(搭配課程畫面截圖)
文字先行:先用 Whisper 轉時間軸逐字稿,再讓 AI 選內容
怎麼做:不要一上來就把 5 分鐘影片丟給 Claude。先請 AI 安裝本機 Faster Whisper(或用你現在 Mac 已裝好的 whisper-cli),把影片轉成帶起訖時間軸的逐字稿。
接著選內容:把逐字稿交給 AI,請它找出講錯、口誤、停頓與重複段落,列出「修改前 vs 修改後」讓你確認,確定要刪哪幾秒後再剪片。
原始 Whisper JSON 充滿每個字的毫秒信心度,1 小時片動輒數萬 Token;務必先轉成極簡
[00:12 - 00:48] 文字 格式再給 Claude 讀。
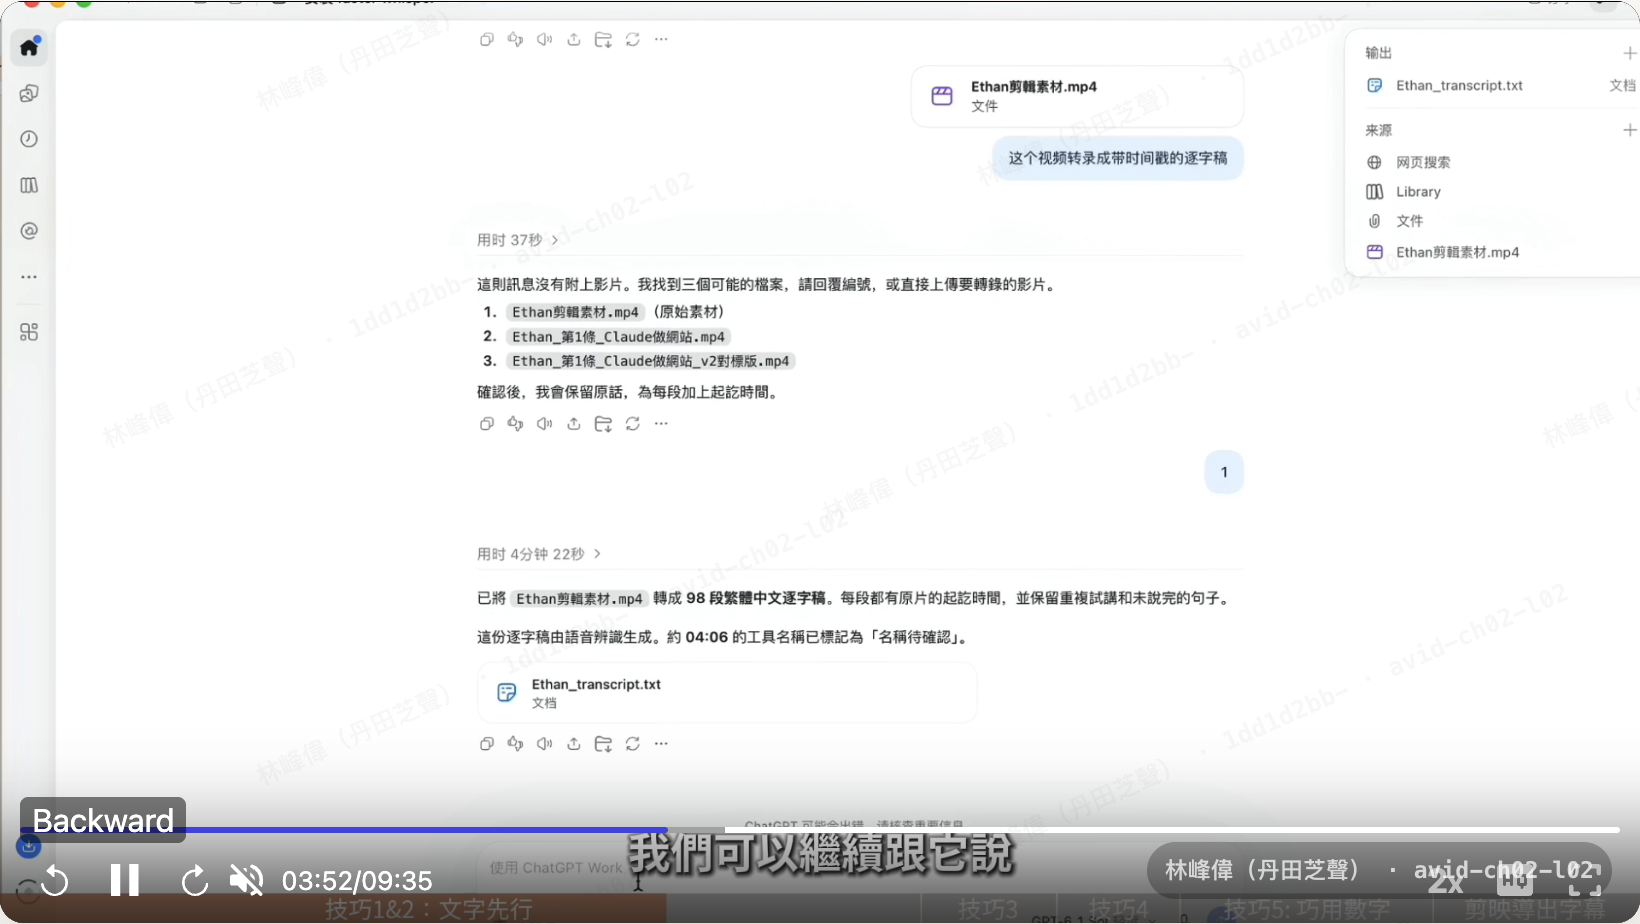
Ethan_transcript.txt(帶起訖時間軸)用 EDL 決策表存檔 + 先測 8 秒小片段再剪全片
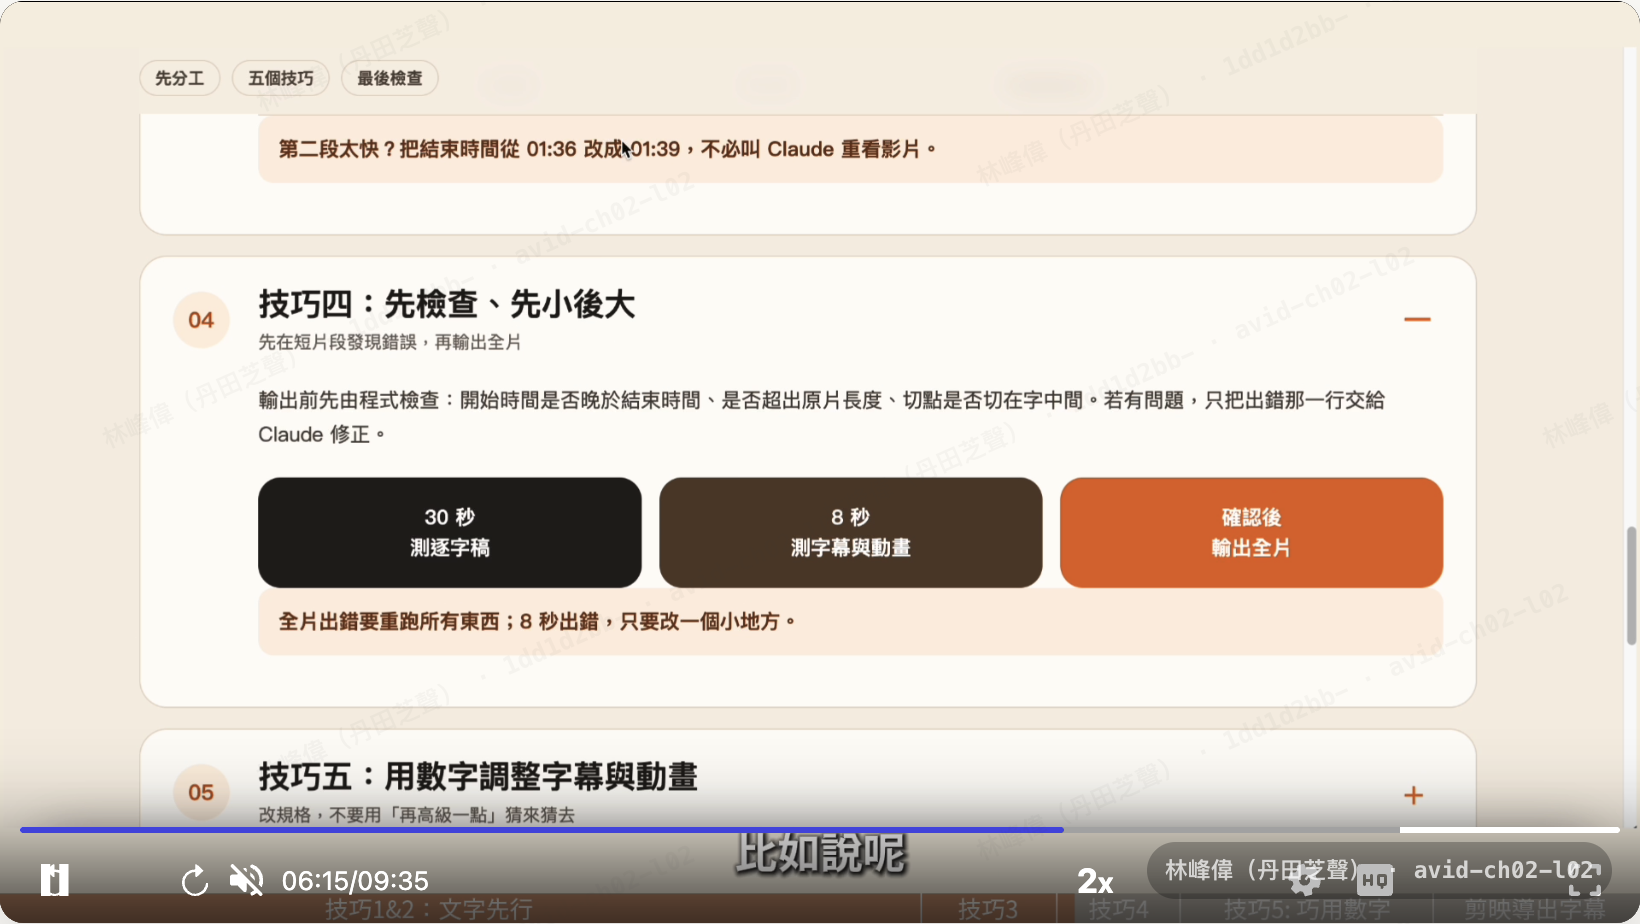
技巧 3|EDL 剪輯決策表:把每段口播文案、保留原因與對應畫面寫成表格(EDL)。之後覺得「第二段太快」,你直接把表裡的 01:36 改成 01:39,讓 Claude 照表改就好,不必重看整支影片。
技巧 4|先小後大:先用 30 秒測逐字稿、再用 8 秒測字幕與動畫效果,確認版型 OK 後才輸出整支全片。8 秒出錯只要改一個小地方,全片出錯就得重跑全部!
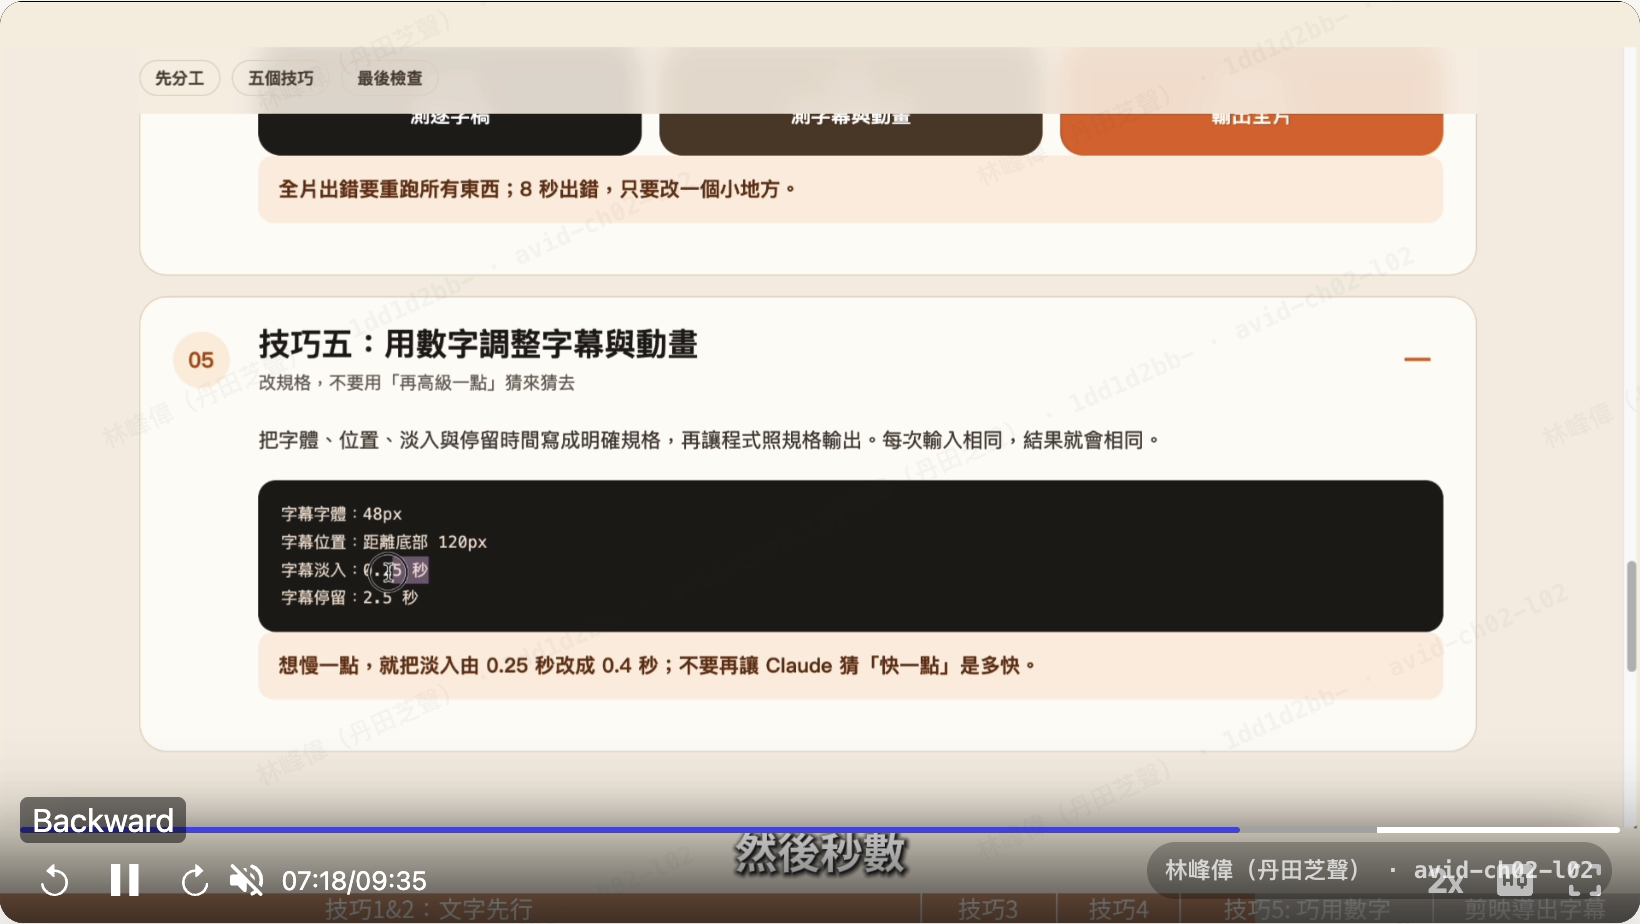
用「精準數字」調整字幕與動畫(別讓 AI 猜)
不要這樣講:「字體放大一點」、「字幕往下一點」、「彈出快一點」——這些模糊詞會讓 AI 每次猜不同數值,來回改 5 次就多燒 5 倍 Token。
要這樣下指令:
- 字幕字體:
48px - 字幕位置:距離底部
120px - 字幕淡入:
0.25 秒(想慢一點就改0.4 秒) - 字幕停留:
2.5 秒
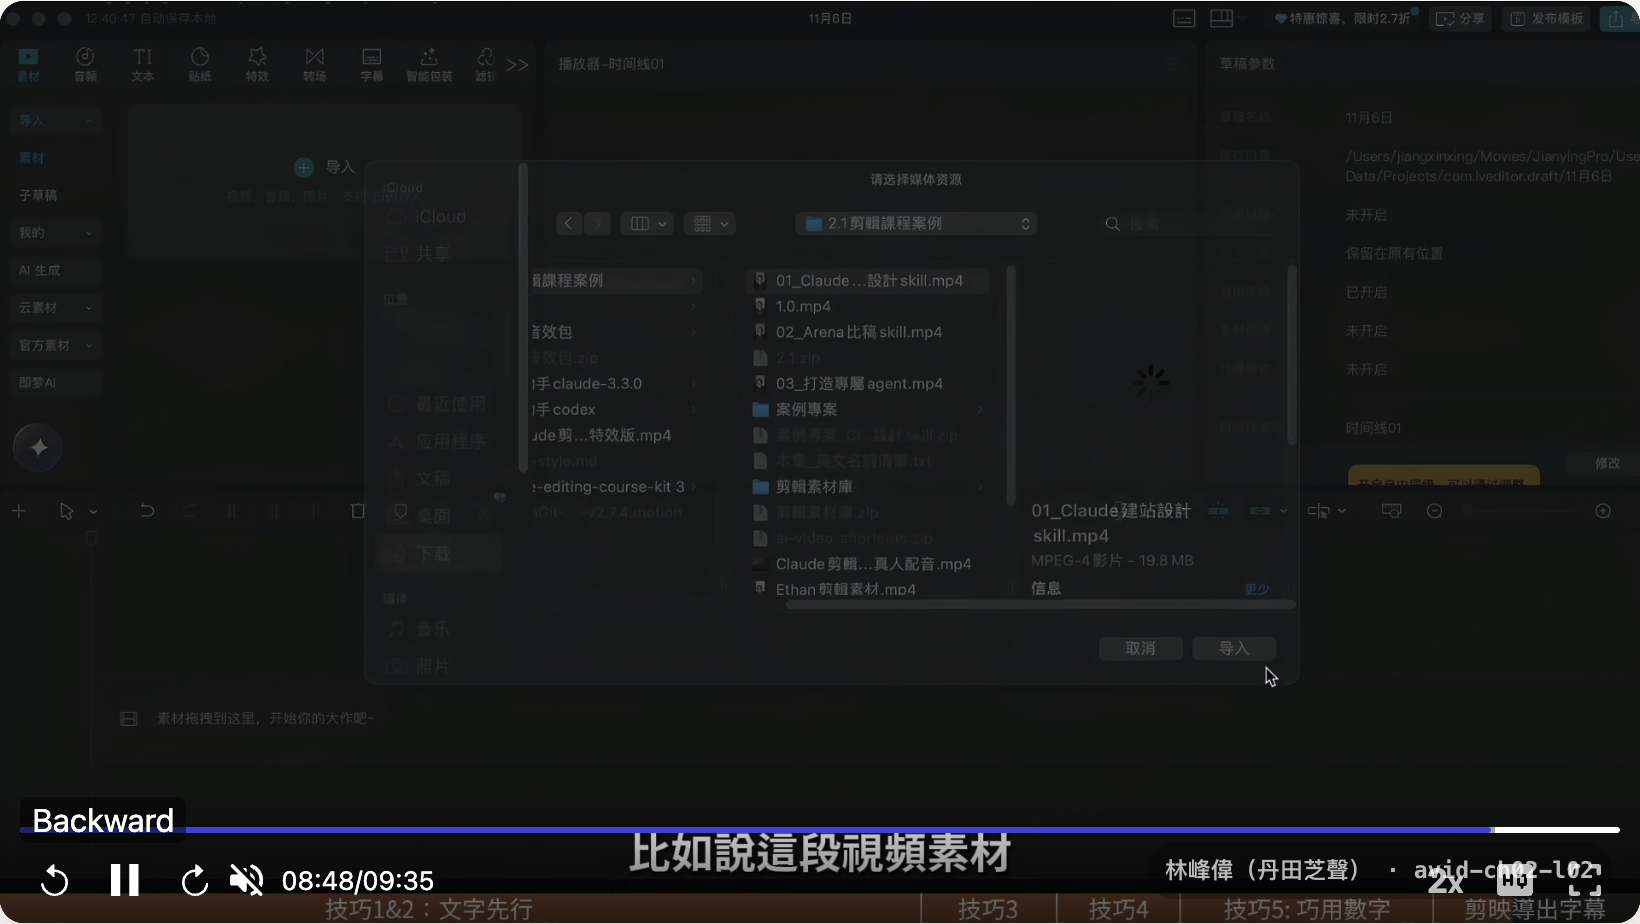
連 AI 都不想開?用剪映「只匯出 SRT 字幕」零 Token
操作步驟:打開剪映專業版 → 匯入素材拖到時間軸 → 點「字幕 → 識別字幕」→ 點右上角「導出」→ 取消勾選「視頻導出」、只勾選「字幕導出(SRT 格式)」。
這樣幾秒鐘就能拿到帶精準時間軸的 .srt 檔,完全不花任何 AI Token!
.srt 字幕(零 AI 算力成本)4. 2026 官方省錢新招與避坑地雷(影片沒講到的關鍵)
新招 ①:定案後立刻 /clear 再剪片
為什麼有效:對話每多一輪都會重送歷史紀錄。當你讀完逐字稿、把剪輯時間點存進 cut_list.json 或 EDL 表格後,直接執行 /clear 清空對話,開新視窗只讀這份表格來跑 FFmpeg,總花費直降 70%!
地雷 ①:過度依賴 /compact 導致失憶
問題出在哪:自動壓縮是有損壓縮,常把「保留 0.3 秒呼吸氣口」、「絕對不覆蓋原始母帶」等負面禁令洗掉。
解法:若要用壓縮,改下指令:/compact 只保留 cut_list.json 路徑與不可覆寫原檔規範。
地雷 ②:用 Haiku 寫複雜 filter_complex
問題出在哪:Haiku 很便宜,適合拿來當 Subagent 讀目錄和 ffprobe;但寫多段轉場或雙語字幕座標容易出錯,來回修 5 輪反而比用 Sonnet 一次寫對更貴。
地雷 ③:對話途中切模型毀掉 Prompt Cache
原理:Anthropic 快取命中只要 0.05x~0.1x 費用,但每個模型快取獨立。開局鎖定模型就別中途用 /model 切換,否則整個系統前綴重算全額!
想看「丹田芝聲」40 分鐘出遊片省 Token 五步流水線(實戰對齊)
- 本機離線前處理(0 Token):Mac 本機跑
whisper-cli轉出乾淨.srt,禁止把原始 Whisper JSON 餵給 Claude。 - Haiku Subagent 盤點(極低成本):派
media-scout跑ffprobe確認素材解析度與 fps,只回傳 5 行摘要表。 - Sonnet 一次規劃 EDL:讀
.srt挑出小靈芝&小檸檬高光互動段,存成cut_list.json。 - 執行
/clear+ 8 秒試剪:清空逐字稿歷史後只讀cut_list.json,先剪 8 秒樣板用數字調好48px字幕與 Mach264_videotoolbox加速。 - 全片輸出 + 9 宮格抽檢:用 FFmpeg 抽 1 張 9 宮格截圖檢查字幕沒遮到雙寶臉部,總 Token 可壓低至傳統做法的 20%~30%。
5. 省 Token 技巧優先順序象限圖
6. 可直接複製的成品(一鍵複製)
成品 A|省 Token「選內容 + 出 EDL」標準指令
請讀取 ./transcript_clean.srt,幫我挑出「口誤、重複講、超過 1.5 秒空白」的句子編號,列出「修改前 vs 修改後」摘要表並輸出 ./edl_plan.json。請先只針對前 8 秒製作測試字幕(字體 48px、距離底部 120px、淡入 0.25 秒、停留 2.5 秒),確認效果後再處理全片。
成品 B|極低成本素材盤點 Subagent(.claude/agents/media-scout.md)
---
name: media-scout
description: 盤點影音素材目錄、用 ffprobe 檢查解析度與 fps、抽檢字幕時間碼異常
tools: Bash, Read, Glob, Grep
model: haiku
---
執行後僅回傳「檔案清單、總時長、解析度/fps、異常警告」精簡 5 行摘要,嚴禁貼上完整 ffprobe JSON 或轉檔進度條。
成品 C|省 Token 全域環境設定(~/.claude/settings.json)
{
  "env": {
    "ENABLE_TOOL_SEARCH": "auto:5",
    "MAX_THINKING_TOKENS": "8000"
  }
}